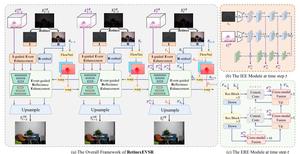
本文提出RetinexEVSR,首个事件驱动的低光视频超分辨率框架。该框架利用高对比度事件信号与Retinex先验,通过双向跨模态融合策略,有效整合噪声事件数据与退化RGB帧中的有用信息。其中,照明引导事件增强模块利用Retinex模型导出的光照图逐步细化事件特征,抑制低光伪影并保留高对比度细节;事件引导反射率增强模块则通过多尺度融合机制动态恢复反射率细节。实验表明,该方法在三个数据集上达到最优性能,在SDSD基准上相比先前事件方法提升2.95 dB,并减少65%运行时间。
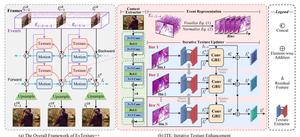
本文提出EvTexture++,一种事件驱动的视频超分辨率纹理增强框架。与以往将事件用于运动估计不同,该方法利用事件的高频时空细节显式恢复纹理,通过定制纹理增强分支和迭代纹理增强模块,逐步挖掘高时间分辨率事件信息,实现纹理区域的渐进细化,从而生成更精确、细节更丰富的高分辨率视频。该框架还可作为即插即用模块提升现有VSR模型性能。
本文提出MeDKCoOp,一种面向生物医学视觉语言模型的双知识引导图提示学习方法。该方法系统整合医学领域知识,从文本与视觉分支提取专门知识并构建图结构表示,通过知识引导的关系转移实现跨模态融合,并动态优化可学习提示,以增强CLIP等模型在医学下游任务中的适应能力。实验表明其在多个生物医学基准上取得优异性能。
本文针对脑肿瘤多模态MRI诊断中融合策略受限于样本稀缺的问题,提出多模态监督对比学习方法MMSupcon。该方法通过多模态医学图像融合生成信息丰富的样本,并设计多模态监督对比损失,引导模型有效整合互补模态信息,提升诊断准确性。
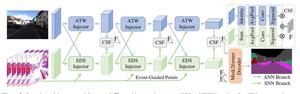
本文提出一种高效的混合神经网络框架,用于事件相机语义分割。该框架包含处理事件流的脉冲神经网络(SNN)分支和处理帧图像的人工神经网络(ANN)分支,并设计了自适应时间加权(ATW)注入器、事件驱动稀疏(EDS)注入器和通道选择融合(CSF)模块,以充分融合帧与事件的互补时空信息。在DDD17-Seg、DSEC-Semantic和M3ED-Semantic数据集上取得了最先进精度,并在DSEC-Semantic上降低63%能耗。
本文提出一种具有可控变异性的多模态扩散分割网络(MMDSN),用于医学图像分割。该方法通过医学文本注释实现多模态条件控制,增强视觉语义表示的一致性,并建立视觉与语言之间的对应关系。同时,MMDSN 在潜在高斯空间中对多个时间步的不确定性分布进行约束,从而控制每个去噪时间步的变异性,减少扩散模型随机采样带来的分割偏差。在 Qata-Covid19 等数据集上的实验验证了其有效性。